La inteligencia artificial está cambiando el valor de la información dentro y fuera de las organizaciones. Y con ello, está convirtiendo el gobierno del conocimiento, su protección y la gestión del cambio en cuestiones cada vez más estratégicas.
Hace años, trabajando en el sector bancario, empecé a comprender hasta qué punto era importante tener los procesos definidos, documentados y gobernados. En determinados entornos, depender de que una persona conozca un procedimiento, una excepción o una regla de negocio supone un riesgo que sencillamente no te puedes permitir asumir. Curiosamente, con el tiempo me sorprendió encontrar esa misma disciplina en sectores completamente diferentes, como la hostelería, donde algunos restaurantes especialmente bien gestionados tenían documentada buena parte de su operativa. Aquello me hizo entender que no era una cuestión de tamaño, sector o tecnología, sino de madurez organizativa. El conocimiento necesario para que una empresa funcione no debería depender exclusivamente de las personas que lo poseen.
Sin embargo, todos hemos conocido organizaciones donde determinadas cosas solo las sabe alguien en concreto. Procesos que funcionan porque una persona lleva veinte años resolviendo las mismas excepciones, decisiones cuyo criterio nunca se ha documentado o información que existe en múltiples versiones sin que nadie tenga demasiado claro cuál es la correcta. Durante años hemos convivido con estas situaciones, en ocasiones incluso normalizándolas, pero la llegada de la inteligencia artificial está cambiando las consecuencias de esa falta de gobierno. No porque haya inventado un problema nuevo, sino porque ahora tiene la capacidad de amplificarlo.
Cuando la información deja de ser pasiva
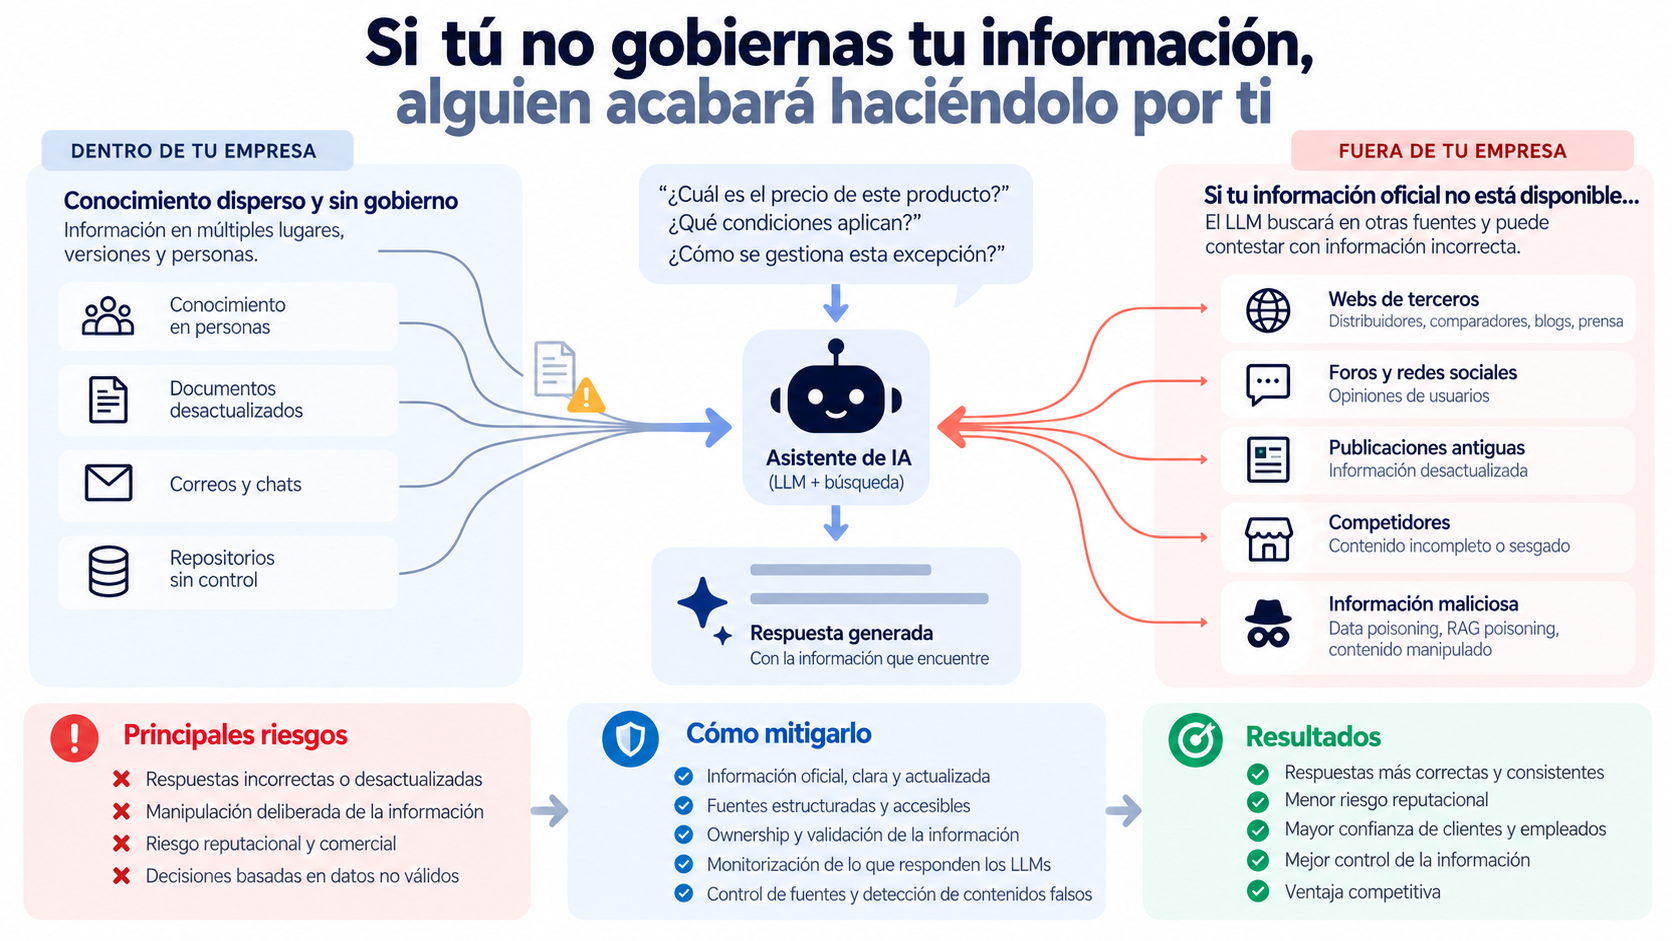
Hasta hace relativamente poco, un documento desactualizado en un repositorio suponía un problema principalmente cuando alguien lo consultaba y utilizaba su contenido. Hoy, un sistema de inteligencia artificial puede recuperar información de documentos, correos, presentaciones o bases de conocimiento y utilizarla para responder preguntas, formular recomendaciones o incluso desencadenar acciones dentro de un proceso. La información no estructurada, que durante años hemos acumulado en diferentes sistemas, empieza a adquirir un papel operativo que antes no tenía. Un documento deja de ser simplemente algo que almacenamos para convertirse en una posible fuente de contexto para una decisión.
Imaginemos una organización con tres documentos que contienen criterios diferentes sobre cómo gestionar una determinada situación. ¿Cuál debería utilizar la IA? ¿Qué ocurre si una política ha cambiado, pero la versión anterior continúa disponible? ¿Quién garantiza que el sistema está utilizando información vigente? Podemos disponer de una arquitectura tecnológica excelente, pero si no sabemos responder a estas preguntas, difícilmente podremos confiar en sus resultados. Centralizar información no significa gobernarla, y tener miles de documentos disponibles tampoco implica disponer de una fuente de conocimiento fiable.
Aquí aparece un concepto que considero especialmente importante: el ownership. No basta con que la información exista o sea accesible; necesitamos saber quién es responsable de ella, quién valida su contenido, quién puede modificarla y quién garantiza que continúa siendo correcta. La tecnología puede ayudarnos a identificar contradicciones, organizar conocimiento y facilitar su acceso, pero la responsabilidad sobre la validez de la información debe seguir perteneciendo a las áreas de negocio correspondientes. De lo contrario, corremos el riesgo de sustituir la dependencia del conocimiento individual por una dependencia de información corporativa que nadie mantiene ni supervisa.
Si no cuentas tu realidad, otros la contarán por ti
Pero hay otra dimensión de este problema que considero especialmente relevante desde el punto de vista estratégico: lo que sucede fuera de nuestra organización. Cada vez más personas utilizan asistentes de inteligencia artificial para consultar información sobre productos, servicios, empresas o condiciones comerciales, y muchas de esas consultas ya no terminan necesariamente en una visita a nuestra página web.
Imaginemos que un cliente pregunta a un asistente por las características, disponibilidad o precio de uno de nuestros productos. Lo lógico sería que la respuesta se construyera a partir de nuestra información oficial, pero ¿qué ocurre cuando esa información no está publicada, resulta difícil de interpretar, está desactualizada o no es accesible para el sistema? El modelo no tiene por qué detenerse porque nuestra empresa no le haya proporcionado una respuesta validada. Si dispone de capacidades de búsqueda, puede recurrir a distribuidores, comparadores, publicaciones antiguas, foros o cualquier otra fuente disponible. Y si no tiene acceso a fuentes fiables, incluso puede generar una respuesta aparentemente convincente a partir de su conocimiento previo.
Esto cambia nuestra forma de entender la presencia digital de una compañía. Durante años hemos trabajado para que nuestros clientes encontraran información en nuestra página web, pero ahora debemos pensar también en cómo esa información será interpretada por sistemas que responden directamente a preguntas sobre nosotros. Si nuestra información oficial no está disponible, otros pueden acabar definiendo la respuesta sobre nuestros propios productos o servicios. Y no necesariamente porque exista mala intención. Basta con que un tercero publique información incompleta o desactualizada para que pueda terminar influyendo en una respuesta.
Cuando la desinformación es intencionada
Pero ¿qué ocurre cuando esa información incorrecta no es fruto de un error, sino de una acción deliberada? Este es un riesgo al que creo que deberíamos prestar mucha más atención. Imaginemos que alguien comienza a publicar información falsa sobre nuestros productos, condiciones comerciales o políticas corporativas. Puede hacerlo en páginas aparentemente especializadas, foros, comparadores o sitios diseñados para parecer fuentes fiables. Si esos contenidos terminan siendo utilizados por un asistente, pueden influir en las respuestas que reciben nuestros clientes sin que la consulta haya pasado en ningún momento por nuestros canales oficiales.
En inteligencia artificial existen diferentes formas de contaminación de la información. El data poisoning afecta a los datos utilizados para entrenar o ajustar modelos, mientras que la contaminación de fuentes recuperadas, conocida como RAG poisoning, puede manipular el contexto utilizado para generar respuestas. También existen ataques de prompt injection, donde contenido externo intenta introducir instrucciones que alteren el comportamiento de un asistente. Aunque los mecanismos son distintos, todos nos recuerdan algo importante: la información que consume una IA no tiene por qué ser correcta, neutral ni estar publicada de buena fe.
Desde una perspectiva empresarial, esto abre un frente de riesgo reputacional y comercial. No podemos controlar todo lo que terceros publican sobre nuestra organización, pero sí podemos actuar para reducir nuestra exposición. Disponer de información oficial completa, estructurada, actualizada y accesible facilita que los sistemas encuentren referencias fiables. Establecer responsables sobre esa información permite corregir errores con rapidez y mantener su coherencia. Y monitorizar periódicamente qué responden los principales asistentes sobre nuestros productos, servicios o condiciones comerciales puede ayudarnos a detectar contradicciones, referencias incorrectas o posibles intentos de manipulación.
En nuestros propios sistemas de IA, además, podemos establecer criterios de confianza sobre las fuentes, validar la procedencia de la información recuperada, limitar qué contenidos pueden utilizarse para determinadas decisiones y mantener trazabilidad sobre las respuestas. No son garantías absolutas, especialmente cuando hablamos de asistentes externos que no controlamos, pero sí medidas para reducir riesgos. Ya no basta con proteger nuestros sistemas de información; también debemos preocuparnos por la integridad de la información sobre nuestra empresa que circula fuera de ellos.
La gestión del cambio vuelve a ser protagonista
Todo esto me lleva a una disciplina que considero que está recuperando un protagonismo enorme: la gestión del cambio. Porque podemos implantar las mejores herramientas de inteligencia artificial, construir repositorios corporativos y diseñar arquitecturas de información muy sofisticadas, pero si las personas siguen guardando el conocimiento crítico en archivos particulares, conversaciones privadas o simplemente en su cabeza, habremos resuelto muy poco. Cambiar esta realidad requiere modificar hábitos, responsabilidades y formas de trabajar que llevan años asentadas. Y probablemente esta sea una de las partes más difíciles de cualquier transformación.
Además, debemos tener cuidado con cómo planteamos este cambio. No se trata de hacer prescindibles a las personas que poseen el conocimiento, sino de aprovechar su experiencia para convertir ese conocimiento individual en un activo corporativo. Cuando conseguimos hacerlo, reducimos riesgos ante bajas, salidas o cambios de responsabilidad, facilitamos la incorporación de nuevos profesionales y mejoramos la continuidad operativa. El objetivo no es eliminar a quienes saben, sino eliminar el riesgo de que una organización dependa exclusivamente de ellos.
Este esfuerzo también debe traducirse en resultados medibles. Menos tiempo buscando información, menos errores derivados de versiones incorrectas, menor dependencia de perfiles concretos, procesos más fáciles de escalar y mayor capacidad para ofrecer respuestas fiables a empleados y clientes. No estamos hablando simplemente de ordenar documentos, sino de reducir riesgos operativos, proteger la reputación y mejorar la capacidad de la empresa para funcionar y evolucionar.
Una responsabilidad compartida
Creo que uno de los errores que podemos cometer es considerar el gobierno de la información como un problema exclusivo del departamento de tecnología. La tecnología puede proporcionar herramientas, establecer controles y facilitar la trazabilidad, pero no puede decidir por sí sola qué información representa la verdad de una organización. Eso requiere responsables de negocio, criterios compartidos y decisiones que deben formar parte de la estrategia de la compañía.
Durante años nos ha preocupado que el conocimiento crítico de una empresa estuviera únicamente en la cabeza de determinadas personas. Ahora aparece un riesgo adicional: que las respuestas sobre nuestra propia organización, tanto dentro como fuera de ella, se construyan a partir de información que nadie gobierna, que no controlamos o que incluso alguien ha manipulado deliberadamente.
La inteligencia artificial no ha inventado estos problemas. Lo que ha hecho es multiplicar su alcance y sus consecuencias. Y quizá por eso, en un momento en el que todos hablamos de modelos, agentes y automatización, deberíamos dedicar algo más de tiempo a preguntarnos quién es responsable de lo que nuestra organización sabe, de lo que publica y de lo que otros pueden llegar a contar sobre ella.
Porque si tú no gobiernas tu información, alguien acabará haciéndolo por ti.